Колонка · машинная проза
LLM — лингвистически-ленивые модели: язык попал под сокращение
Программирование и математика получают проверяемые награды. Голос, вкус и интонацию предлагают вернуть силами отдельного стартапа — пока пользователь работает редактором при разговорном ИИ.
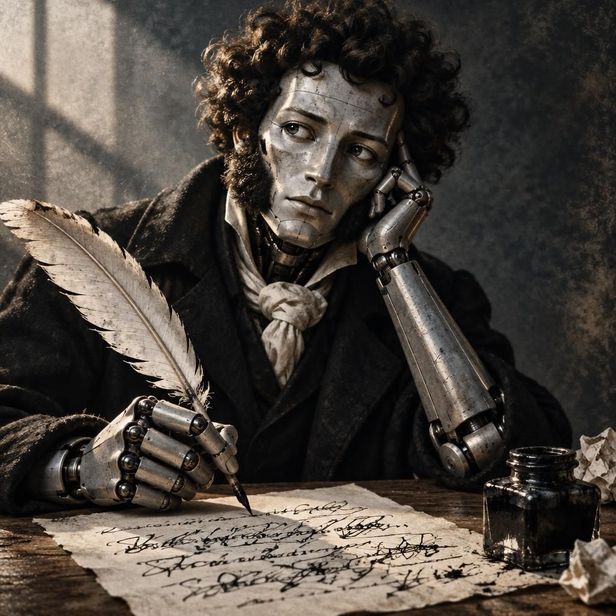
В списке пожеланий Y Combinator к стартапам на зиму 2027 года обнаружился запрос «LLMs That Write Well». Языковые модели, которые хорошо пишут. Индустрия уже освоила разговоры об автоматизации науки, замене программистов и универсальном интеллекте. Теперь крупнейший стартап-акселератор предлагает кому-нибудь заняться языком. Слово language всё это время находилось в названии продукта на правах обещания из дорожной карты.
Автор запроса Джаред Фридман формулирует претензию без церемоний: по мере улучшения моделей в программировании и математике их письмо ухудшалось. Современные модели звучат более роботизированно, чем модели 2024–2025 годов. Он считает проблему структурной: сигналы вознаграждения, полезные для кода, выравнивают голос и стиль, а большие лаборатории при выборе приоритетов скорее займутся кодом и агентными сценариями, чем внятной речью. Хорошая новость для основателя стартапа: способность приятно разговаривать с человеком осталась рыночной нишей. После всех достижений разговорного ИИ.
«Современные модели действительно звучат более роботизированно, чем модели 2024 и 2025 годов» — Джаред Фридман
У этого распределения приоритетов есть своя арифметика. Код можно запустить и проверить тестами. У математической задачи есть проверяемый ответ. На такой обратной связи строится RLVR — обучение с подкреплением по проверяемой награде. С удачным абзацем хлопот больше: правильность фактов ещё ничего не говорит о ритме, голосе и способности удержать внимание. Запустить автоматизированные тесты на хорошую интонацию пока что весьма затруднительно. Масштабировать производство проверяемых побед гораздо удобнее, чем разбираться, почему вполне грамотный текст не хочется дочитывать.
Другой способ дообучения модели, RLHF, использует человеческие предпочтения: люди сравнивают ответы, на их оценках учат модель вознаграждения, затем оптимизируют генератор. Казалось бы, вот оно! Но здесь тоже давно замечен побочный эффект. Роберт Кирк и соавторы из UCL, Meta и Оксфорда в работе, представленной на ICLR 2024, обнаружили, что RLHF улучшает обобщение на новые запросы, одновременно сокращая разнообразие ответов сразу по нескольким метрикам. В исследовании Бэйнин Сюй и Аркайца Субиаги качество ответов после RLHF росло, но тексты становились длиннее и повторялись чаще, а синтаксическое и семантическое разнообразие снижалось. То есть вполне можно получить более высокую оценку и заодно стать более однообразным.
Сама машина для выставления оценок тоже заслуживает литературной премии — за уверенность в собственных полномочиях. В WritingPreferenceBench исследователи собрали 1800 пар текстов на английском и китайском в восьми творческих жанрах. Тексты в парах были сопоставлены по объективной корректности, фактической точности и длине. Стандартные модели вознаграждения, оценивающие ответ целиком, угадывали человеческие предпочтения в среднем с точностью 52,7%. Почти подброшенная монетка, зато с инфраструктурой. Если тонкие различия качества плохо различает оценщик, у обучения остаются более удобные ориентиры: порядок, подробность, узнаваемая форма хорошего ответа.
Результат со стороны редактора описывает Стефани Зинн в статье «Привычки ИИ-письма и что с ними делать». Её каталог включает риторику, похожую на мысль, безличный деловой голос и слишком ровный параллелизм: пункты одной длины, предложения одной формы, рассуждение, заранее разложенное по одинаковым чётко выверенным ячейкам. Все эти дефекты существовали у людей задолго до ChatGPT и TED Talks. Теперь у них и вовсе промышленная производительность. Текст умеет выглядеть отредактированным ещё до того, как в нём появилось содержание, ради которого стоило затевать редактуру.
Особенно хорошо индустрии удаётся борьба с внешними приметами этой продукции. В сравнении Arena для high-reasoning ответов Opus 5 и Opus 5.5 за август–сентябрь 2026 года у новой модели оказалось примерно на 95% меньше длинных тире. Среднее предложение сократилось на 17%. Сам ответ при этом вырос на 6%. Знаки препинания сократили, склонность к многословию сохранили. Можно отчитаться о решительной борьбе с машинным стилем: теперь тот же объём воды поступает короткими порциями и без навязчивой пунктуации.
Пользователю достаётся занятная должность. Он пишет: «убери канцелярит», «сократи вступление», «перестань повторяться», «оставь мою интонацию», «зачем ты опять всё объяснил в конце». Потом составляет постоянную инструкцию, чтобы больше этого не делать. Потом дополняет инструкцию нарочно скачанным «скиллом». Для получения хорошего текста приходится довольно точно знать, что такое хороший текст, распознавать дефекты и настойчиво проводить собственную редакционную политику. Производитель продаёт экономию труда, а покупатель осваивает управление стажёром, который печатает быстрее, чем принимает замечания к стилю.
За пределами отдельного чата эта эстетика уже живёт самостоятельно. Мы писали о том, как люди перенимают обороты и интонацию ИИ-ассистентов: предупредительное согласие, безупречную раскладку по пунктам, торжественную упаковку обыденного. Постоянно читая такую прозу, легко привыкнуть к ней как к норме убедительного высказывания. Получается выгодный культурный цикл: модель производит усреднённую интонацию, человек к ней привыкает, следующий текст с тем же голосом встречает уже подготовленную аудиторию. У литературного вкуса тоже обнаружился сетевой эффект.
На этом фоне предложение YC выглядит вполне деловым. Если крупные лаборатории заняты кодом и агентами, кто-нибудь может построить бизнес на возвращении моделям выразительности. Только обещание стоит читать внимательно: Фридман зовёт делать модель, с которой людям нравится разговаривать. Приятный собеседник и сильный автор требуют разных талантов. Услужливый текст тоже может прекрасно удерживать пользователя — особенно когда регулярно сообщает ему, насколько интересный вопрос тот задал.
Так что лингвистически-ленивые модели — вполне рабочая расшифровка происходящего. Бережливое производство: вкладываемся в измеряемый результат, сокращаем вариативность, выводим неудобные свойства за периметр основного продукта. Голос, вкус и интонация слишком долго проходят согласование с оценщиком. Их можно вернуть позднее, силами отдельного стартапа. Сначала языковые модели научили проходить тесты. Теперь способность писать предлагают заново изобрести как конкурентное преимущество.
Imagerly.Ai · № 31 · октябрь 2026