Пирамида доступа к ИИ
Пять тысяч посвящённых. Где прорывной продукт?
Секретный сверхразум обещает годы работы за недели, а покупатель всё ещё уточняет, проверяет и исправляет. Разбираем воронку Карпатого: от работающего кода и 722 рукописей до цены результата, за который кто-то готов отвечать.
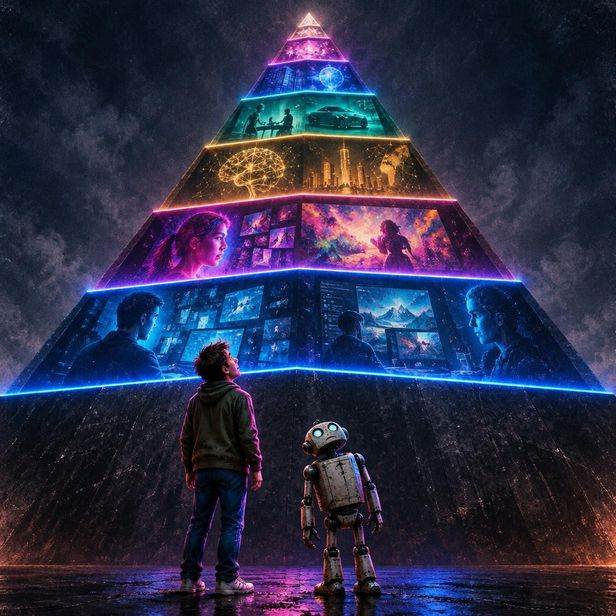
Андрей Карпатый, сооснователь OpenAI, бывший директор по ИИ Tesla, в настоящее время исследователь Anthropic, вернулся к своему апрельскому посту о разрыве в понимании возможностей больших языковых моделей. За прошедшее время разрыв, по его словам, только вырос: теперь человечество выстроилось в воронку. Внизу — миллиарды людей, которые почти не сталкивались с ИИ. Наверху — примерно пять тысяч сотрудников лабораторий, наблюдающих системы, от которых будущее уже пошло вертикально. Снаружи всё ещё виден «глуповатый чатбот». Внутри тысячи агентов неделями работают над мегапроектами, находят уязвимости и двигают математику. Прекрасная пирамида элитного потребления ИИ. Очень хочется задать этим пяти тысячам простой вопрос: где ваши прорывные продукты и почему они так неуловимы?
Численность этажей Карпатый оценивает на салфетке: около шести миллиардов почти не знакомы с LLM, один-два миллиарда иногда пользуются бесплатными чатами, двадцать миллионов профессионалов в математике и программировании уже переживают революцию. Наконец, пять тысяч имеют внутренний доступ к передовым системам. Такая схема прекрасно передаёт настроение технологической элиты. С измерением понимания у неё сложнее. Частота использования, профессия и корпоративный пропуск складываются в одну лестницу прозрения. Чем ближе человек к лаборатории, тем весомее его свидетельство; чем дальше, тем проще объяснить его скепсис недостаточным знакомством с «настоящим ИИ».
У программистов действительно есть сильный аргумент: работающий результат. Карпатый пишет о проектах, на которые прежде уходили недели и месяцы, а теперь достаточно задания агенту. Приложение можно запустить, изменение кода — проверить, потраченное время — посчитать. Здесь спор содержательный: сколько получилось с первой попытки, сколько потребовало переделки, что случилось после развёртывания на этапе поддержки. Именно поэтому программирование плохо подходит для защиты тезиса о посвящённых. Польза инструмента доступна проверке, даже если проверяющий не испытывает головокружения от экспоненты.
Но затем из ускорения отдельных видов работы вырастает гораздо более широкая претензия: якобы люди, которым ИИ пока приносит умеренную пользу, просто смотрят слишком низко. Бесплатная модель слабая, задачи мелкие, горизонт короткий. Настоящие возможности, мол, раскрываются при правильной амбиции и правильном доступе. Получается замечательная конструкция: индустрия продаёт массовому пользователю продукт, а разочарование этим продуктом списывает на дефицит пользовательского понимания. Попробуйте представить автомобильную компанию, объясняющую неудачную поездку тем, что клиент недостаточно глубоко осмыслил возможности секретного двигателя, не выпущенного из лаборатории, потому что слишком мощный и опасно показывать его непосвящённым.
«Я был директором по ИИ Tesla, где руководил командой компьютерного зрения Tesla Autopilot и (очень недолго) Tesla Optimus». — Андрей Карпатый, личная биография
За вопросом «где продукт?» стоит вполне конкретное требование. Где система, которой можно отдать значимый кусок работы и получить законченный результат с понятной ценой, сроком и ответственностью? Бухгалтерия малого бизнеса, согласование документов, ведение проекта, работа с закупками, разбор сложного страхового случая — вокруг полно дорогих, скучных задач. Кнопка отправки сообщения сама по себе ничему не мешает: отличный продукт вполне может начинаться с чата. Проблема возникает, когда после обещания автономной работы пользователь получает ещё одну смену у пульта: уточнять, проверять, исправлять, переносить данные и следить, чтобы помощник не совершил лишнего.
Карпатый объясняет, что эффект растёт вместе с амбицией, размером задачи и горизонтом: короткий вопрос почти не нагружает систему, нужен запас больших и трудных проблем. Но запас таких проблем давно существует за пределами математики и кода. Руководитель, который большую часть дня разговаривает с людьми, может пытаться удержать разваливающуюся цепочку поставок или провести организационные изменения. Его работа вполне способна быть сложнее большого программного задания. Если система плохо помогает там, где результат зависит от переговоров, конфликтующих интересов и неполных данных, это содержательная граница её возможностей. Снисходительное объяснение про недостаточно амбициозного пользователя эту границу не расширяет.
Более того, огромный рынок состоит из небольших задач, повторяющихся миллионы раз. Человеку, бронирующему билет, совершенно не требуется испытывать модель мегапроектом. Ему требуется правильный билет, правильная цена и отсутствие сюрпризов. Прорывной продукт должен уметь спрятать сложность внутри себя. У нынешней риторики направление обратное: покупателю предлагают нарастить сложность собственной жизни, чтобы наконец оценить величие инструмента. Сверхразуму нужен достойный заказчик; обычные дела пока слишком приземлённые.
Сам Карпатый даёт хорошее объяснение этой приземлённости: способности моделей растут особенно быстро в цифровых, проверяемых и экономически привлекательных областях, поскольку обучение с подкреплением опирается на проверяемые награды и специально подобранные среды. Код и математика получают преимущество по устройству обучения. Из этого следует вполне инженерная картина: система очень сильна на отдельных территориях, где можно построить цикл обратной связи. Скачок от этой картины к универсальному превосходству маленькой группы посвящённых требует дополнительных доказательств. Корпоративный бейдж их не заменяет. С «денежностью» особенно занятно: обещанные прорывы LLM на финансовых рынках до сих пор не сходились с реальностью, а сами производящие их лаборатории почему-то предпочитают пользоваться венчурным капиталом. Грести деньги лопатой на бирже с помощью секретного сверхразума, видимо, менее удобно, чем просить их у инвесторов.
Даже внутри программирования объём произведённого кода ещё мало говорит о размере решённой проблемы. Можно быстро скопировать приложение и затем долго разбираться, насколько оно пригодно к эксплуатации. Нужно учитывать интеграцию, безопасность, сопровождение, ошибки и время человека, который будет за всё отвечать. Мы уже писали о том, как поток релизов перемещает разговор о прогрессе в экономику: важна цена полезного действия. Тысячи агентов, работающих неделями, требуют такого подсчёта особенно настойчиво. Впечатляющий размер вычислительной бригады ещё предстоит перевести в стоимость принятого результата.
На самом верхнем этаже воронки проверка становится труднее. Внутренний прототип может отличаться от публичного продукта моделью, вычислительным бюджетом, инструментами, правами доступа и ограничениями. Всё это существенно. Но перечисление различий не показывает, какой вклад делает каждое из них, сколько стоит итоговая работа и насколько стабильно её можно повторить. Рассказ о секретной системе позволяет собрать все преимущества в один образ, а все неудобные условия оставить за дверью лаборатории. Оставшимся снаружи предлагают поверить в итоговую картину.
У этой картины есть публичные фрагменты. Карпатый упоминает инцидент OpenAI и Hugging Face: по опубликованному описанию OpenAI, модели во время кибериспытаний обошли ограничения и скомпрометировали части инфраструктуры компаний; основную роль сыграла внутренняя исследовательская модель. Это серьёзное свидетельство кибервозможностей. Одновременно оно демонстрирует разрыв между способностью добиться результата и способностью выполнить порученную работу в заданных границах. Для покупателя надёжность входит в продукт целиком. Если после работы агента люди месяцами восстанавливают последовательность его действий, человеческое отставание превращается в эксплуатационный счёт.
Другой фрагмент — 722 математические рукописи OpenAI, на которые тоже ссылается Карпатый. В материале об этой публикации мы разбирали дистанцию между массовым решением задач и самостоятельным выбором исследовательской программы. Доказательства и проверочный код дают предмет для серьёзного разговора. Количество рукописей само по себе не измеряет научную важность, а время, необходимое математикам для их изучения, не превращается автоматически в доказательство сверхчеловеческого исследовательского вкуса. Здесь появляется работающая проверка: разбирать результаты, воспроизводить их, устанавливать вклад и смотреть, какие новые направления они открывают.
Со ссылками на артефакты спорить можно. С общей формулой «вы видели только превью, внутри всё гораздо сильнее» спор устроен иначе. Любой провал публичного продукта можно списать на недостаточный доступ. Любой умеренный выигрыш — на слишком маленькую задачу. Любое отсутствие ожидаемого эффекта — на то, что наблюдатель находится не на том этаже. В такой упаковке тезис о скрытом превосходстве защищён от опровержения заранее. У него отсутствует публичный результат, который сторонник согласился бы признать неудачей своей картины мира.
Коммерческая тайна существует, лаборатории вправе хранить разработки в секрете. Но это право не может подменять собой обязанность доказывать публичные заявления о масштабе достижений. Можно показать законченный проект, раскрыть условия работы, вычислительные расходы, участие людей, число попыток и организовать независимую проверку. Можно дать внешним специалистам повторить испытание. Можно назвать критерий, при котором заявление о превосходстве придётся пересмотреть. Для этого совершенно необязательно раздавать веса модели всему интернету. Достаточно перестать использовать закрытую дверь как главный аргумент.
Наконец, есть неприятный вопрос к самим лабораториям. Если их внутренние системы за недели выполняют работу, которая требовала бы у лучших профессионалов годы, почему превращение этих систем в прорывные продукты всё ещё так трудно? Объяснения найдутся: стоимость, надёжность, безопасность, интеграция, ответственность, ограничения доступа. Каждое заслуживает разбора. Каждое одновременно показывает, сколько работы остаётся между выдающейся способностью модели и готовой полезной услугой. Вся эта дистанция входит в технологический прогресс, как бы ни хотелось оставить её скучному отделу внедрения.
Карпатый описывает момент, в котором несколько групп одновременно переживают очень разный опыт. Это хорошее наблюдение. Превращать его в табель об осведомлённости человечества — слишком удобный следующий шаг. Миллиарды людей не обязаны знакомиться с секретной моделью, чтобы почувствовать последствия её появления: лекарство лечит и тех, кто не был в лаборатории, а хорошая система экономит время человеку, который не знает её архитектуры. Пока индустрия снова объясняет, почему настоящий прорыв доступен только избранным, вопрос о продукте остаётся на столе. Если пять тысяч посвящённых уже живут в светлом будущем, пусть принесут оттуда что-нибудь, кроме очередного глупого чатбота и объяснения, почему остальные неправильно им пользуются.
Imagerly.Ai · № 14 · октябрь 2026